

één DNA voor Data en Analytics


Lakeflow Spark Declarative Pipelines: een nieuwe standaard voor datapipelines
Tijdens de Data + AI Summit 2025 kondigde Databricks afgelopen zomer de algemene beschikbaarheid aan van de opvolger van Delta Live Tables (DLT). Nadat het framework vorige week nog een extra doopnaam kreeg, heet deze nu voluit Lakeflow Spark Declarative Pipelines, oftewel SDP. SDP belooft een nieuwe standaard te zetten voor de manier waarop we ETL-pipelines bouwen en beheren. Maar hebben we het eigenlijk over, en waarom zou je ze willen gebruiken? OneDNA member Tim Bakker legt je er hier alles over uit.
 Voor de zomer nam ik mij voor om na mijn verbouwing een drieluik blogs te schrijven over Delta Live Tables. Maar terwijl bij mij thuis de vloerverwarming werd aangelegd, werd ook het cloud-leidingwerk van Databricks flink onder handen genomen. Het resultaat: dezelfde stromen van data en warm water, en toch helemaal anders. “Alles stroomt en niets blijft hetzelfde”, sprak de Griekse filosoof Herakleitos ooit. Hij had volkomen gelijk.
Hoog tijd dus voor een deep dive in Lakeflow Spark Declarative Pipelines.
De veranderde werkelijkheid van data-engineering
In nog geen tien jaar tijd is het datalandschap volledig opgeschud. Waar organisaties vroeger vooral te maken hadden met gestructureerde tabellen uit hun CRM- of ERP-systemen, komt data nu overal vandaan: API’s, SFTP-servers, verschillende databases en (event) streams. Een groot deel van die data is bovendien semi-gestructureerd of zelfs ongestructureerd, en wordt steeds vaker real-time verladen in plaats van in batch.
Intussen groeiden in veel organisaties de pipelines juist organisch – een lappendeken van scripts, notebooks en handmatige processen. Elke nieuwe bron vroeg om maatwerk, elk schema om een aanpassing. Streaming en batch werden los van elkaar onderhouden, monitoring zat in losse tools en lineage bestond vaak alleen in het hoofd van de ontwikkelaar. En hoewel alle maatwerk-oplossingen die in de loop van jaren zorgvuldig zijn opgebouwd vaak prima werken, komt de beperkingen hiervan steeds duidelijker naar voren.
De grenzen van de traditionele aanpak
Naarmate de pipelines groeiden, werden ze namelijk complex en kwetsbaar. Een schemawijziging in één bron kon tientallen processen doen falen, batch- en streamingverwerking moesten apart onderhouden worden, foutafhandeling, data lineage en kwaliteit moesten telkens opnieuw gecodeerd worden, en in een woud aan onderlinge afhankelijkheden zag je door de bomen steeds minder bos.
Het resultaat? Een zwak fundament. Het is precies het tegenovergestelde van wat een moderne data-architectuur nodig heeft: betrouwbaarheid, schaalbaarheid en transparantie. Deze situatie vroeg om nieuwe, geïntegreerde en betrouwbare vormen van data-engineering om alle datastromen te beheren.
Het antwoord van Databricks: Delta Live Tables
Op dat pijnpunt sprong Databricks in met de brede introductie van Delta Live Tables (DLT) in 2022, die nu dus van van naam veranderd zijn. Nomen est omen, dus is het denk ik nuttig om beide namen afzonderlijk onder de loep te nemen omdat ze allebei een ander perspectief bieden op de onderliggende technologie. Laten we beginnen bij Delta Live Tables.
Delta verwijst naar Delta Lake, de open opslaglaag boven op je datalake die zorgt voor ACID-transacties, versiebeheer en schema-evolutie. Met Delta Lake werd het mogelijk om data lakes te gebruiken alsof het databases waren: transactioneel, betrouwbaar en consistent. Delta kennen we natuurlijk uit de wiskunde als symbool voor het verschil tussen twee waarden; in onze context kortweg het verschil tussen de tabel van gisteren en die van vandaag.
Het woord Live benadrukt verder dat deze tabellen niet statisch zijn, maar continu en incrementeel ververst (kunnen) worden. Hoewel de verwerking van streamingprocessen een stuk complexer is dan een batchproces, is er voor de gebruiker nauwelijks een verschil in de opzet ervan binnen een DLT-pipeline. De manier van inrichten is vrijwel identiek, terwijl in de verwerking alles wordt behandeld als één vloeiende stroom naar een tabel die altijd up-to-date is.
Tot slot duidt het woord Tables er natuurlijk op dat de output van een pipeline een volwaardige tabel die je direct kunt bevragen met SQL, Python of Scala. Deze tabel is een Delta Lake-tabel, wat wil zeggen dat deze wordt opgeslagen als map met Parquet-bestanden waarin alle wijzigingen (de “delta’s”) op de tabel worden opgeslagen en metadata. Daardoor is de opslag ervan niet alleen heel efficiënt, maar krijg je ook de hierboven onder het kopje Delta beschreven voordelen die je bij traditionele tabellen niet had.
Met Delta Live Tables combineerde Databricks dus het beste van twee werelden:
· De vertrouwde structuur van een traditionele database;
· Het gemak en de flexibiliteit van een datalake;
· En de mogelijkheid om zowel analytische als operationele workloads samen te brengen.
Van DLT naar Lakeflow Spark Declarative Pipelines
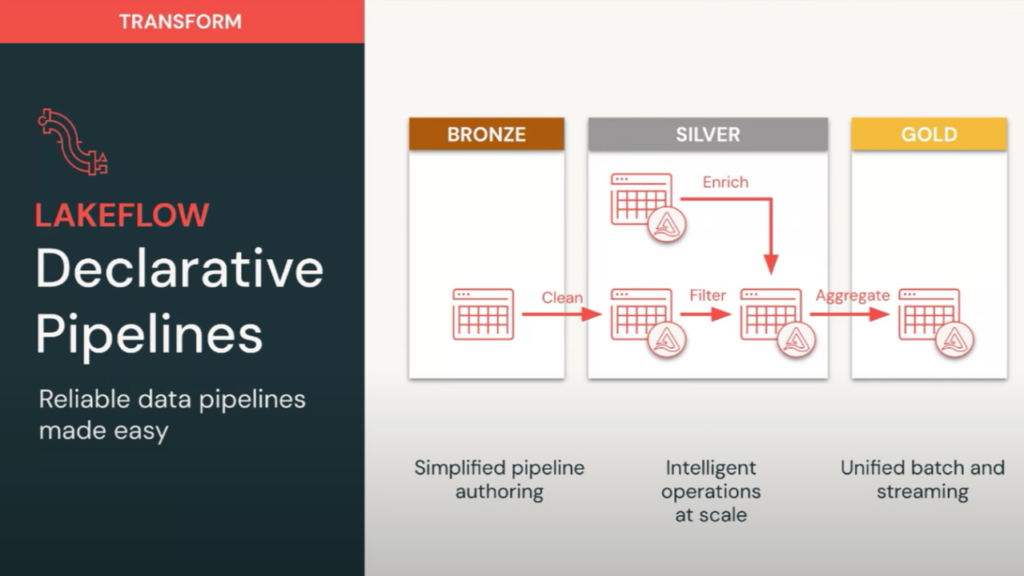
Het DLT-framework kreeg zoals gezegd twee keer een nieuwe naam en daarbij een breder kader: Lakeflow Spark Declarative Pipelines (SDP). De onderliggende technologie – zie hieronder – bleef grotendeels hetzelfde, maar de focus verschoof. De pipelines werden ondergebracht in een breder concept dat door Databricks is uitgerold: Lakeflow, een volledig geïntegreerde data engineering-oplossing. Behalve de pipelines zijn ook Lakeflow Connect en Lakeflow Jobs hier onderdeel van, om samen de continue datastromen door de hele organisatie te beheren.
Over de onderliggende technologie gesproken: Spark. Apache Spark is de letterlijke engine van het framework. Spark zorgt voor de uitvoer van de data-handelingen zoals transformaties, de distributie van dit werk en het clustermanagement om dit zo efficiënt mogelijk uit te voeren. Spark is dus de uitvoerder in de data plane, waarop de orkestratielaag of control plane draait waarmee de gebruiker werkt.
Declarative pipelines vormen een abstractielaag bovenop Apache Spark waarbij je niet langer procedureel beschrijft hoe data moet worden verwerkt, maar declaratief vastlegt wat de tabellen in de workflow zijn en waar ze van afhangen. In plaats van losse Spark-jobs te schrijven (PySpark/SparkSQL/Scala) definieer je iedere tabel als een functie van andere tabellen: een keten van declaraties. Deze declaraties vormen samen de Declarative Pipelines API – de manier waarop je de pipeline beschrijft.
De pipeline-engine interpreteert deze API en bouwt hieruit automatisch een dependency graph. De engine bepaalt zelf de optimale uitvoeringsvolgorde, heruitvoering, incremental processing, retries en hoe state moet worden beheerd. Onder de motorkap vertaalt de engine elke declaratie naar één of meerdere fysieke Spark-plannen. Spark blijft de compute-engine die de transformaties daadwerkelijk uitvoert, maar de declarative engine regelt de orkestratielaag.
Een nieuw fundament
De (re)branding ten spijt, is dat dus waar we het over hebben: het einde van oude lappendekens, breekbare pipelines en de scheiding tussen het data warehouse en het datalake. Het antwoord van Databricks was een modern datafundament waarin we, gebruik makend van de voordelen van Delta Lake en de kracht van de Spark-engine, op een declaratieve manier datastromen kunnen bouwen en beheren en we batch- en streamingdata moeiteloos kunnen integreren zodat onze tabellen altijd up-to-date zijn. Met Lakeflow Spark Declarative Pipelines is dat natuurlijk niet anders.
Dat wil niet zeggen dat er geen sprake is van ontwikkeling van het product, integendeel! Alles stroomt en niets blijft hetzelfde. Databricks bundelde de ervaringen van duizenden gebruikers voor de verdere ontwikkeling van de Declarative Pipelines engine en schonk de API bovendien aan Apache Spark waarmee het open source werd. Op het fundament dat DLT legde bouwt SPD verder aan een declaratieve, geïntegreerde manier van werken waarin datakwaliteit, lineage, orkestratie en monitoring één (visueel) geheel vormen.
Het zijn immers de praktische toepassing en het gebruiksgemak waar het de meeste gebruikers van het framework om te doen is. Uiteindelijk blijft het bouwen van data pipelines een abstract concept zo lang je niet écht inzichtelijk maakt wat er in elke stap van het proces gebeurt – zeker als je die stappen niet meer zelf hoef te definiëren. Dankzij de nieuwe geïntegreerde ontwikkelomgeving die met de naamswijziging mee kwam is dat niet langer een issue.
Hoe dat eruitziet en hoe je dit zelf je eerste Lakeflow Spark Declarative Pipeline bouwt? Goede vraag! Dat laat ik je zien in de volgende blog. Dus stay tuned!